
Case Study
OberpfalzECHO – fast 100.000 Artikel und trotzdem schneller
Als OberpfalzECHO auf den frühen VeloCore Full-Headless-Prototypen umgestellt wurde, umfasste das Portal rund 76.000 Artikel. Heute sind es fast 100.000 Artikel – ein Wachstum von knapp 31,6 %. Gleichzeitig veröffentlicht die Redaktion weiterhin hunderte neue Artikel pro Woche. Normalerweise würde man bei einem immer größeren WordPress-System zumindest erwarten, dass die Performance unter diesem Wachstum nicht besser wird.
Architektur
WordPress verwaltet – VeloCore liefert aus
OberpfalzECHO läuft auf einem frühen VeloCore-Ansatz, noch vor dem heutigen intelligenten Fast-Path-Runtime-Modell. Die Architektur arbeitet vollständig datengetrieben:
WordPress bleibt dabei das Redaktionssystem. Das öffentliche Frontend muss jedoch nicht für jeden Besucher erneut den vollständigen WordPress-Stack mit dessen Datenbankabfragen, Theme-Verarbeitung, Plugins und Query-Logik durchlaufen.
Die öffentliche Auslieferung arbeitet stattdessen auf einer vorbereiteten Datenbasis. Dadurch ist die Runtime des Frontends weitgehend von der Größe der eigentlichen WordPress-Installation entkoppelt. Das ist bei OberpfalzECHO besonders interessant, weil das Portal seit der Migration von etwa 76.000 auf fast 100.000 Artikel gewachsen ist.
Die Entwicklung auf einen Blick
| Kennzahl | Vor VeloCore | Nach VeloCore | Veränderung |
|---|---|---|---|
| TTFB p75 | 1.636 ms | 285 ms | −82,6 % |
| FCP p75 | 3.364 ms | 838 ms | −75,1 % |
| LCP p75 | 3.865 ms | 1.219 ms | −68,5 % |
| CLS p75 | 0,30 | 0,00 | praktisch eliminiert |
| INP p75 | 139 ms | 97 ms | −30,2 % |
| Artikelbestand | ca. 76.000 | ~100.000 | >+31,6 % |
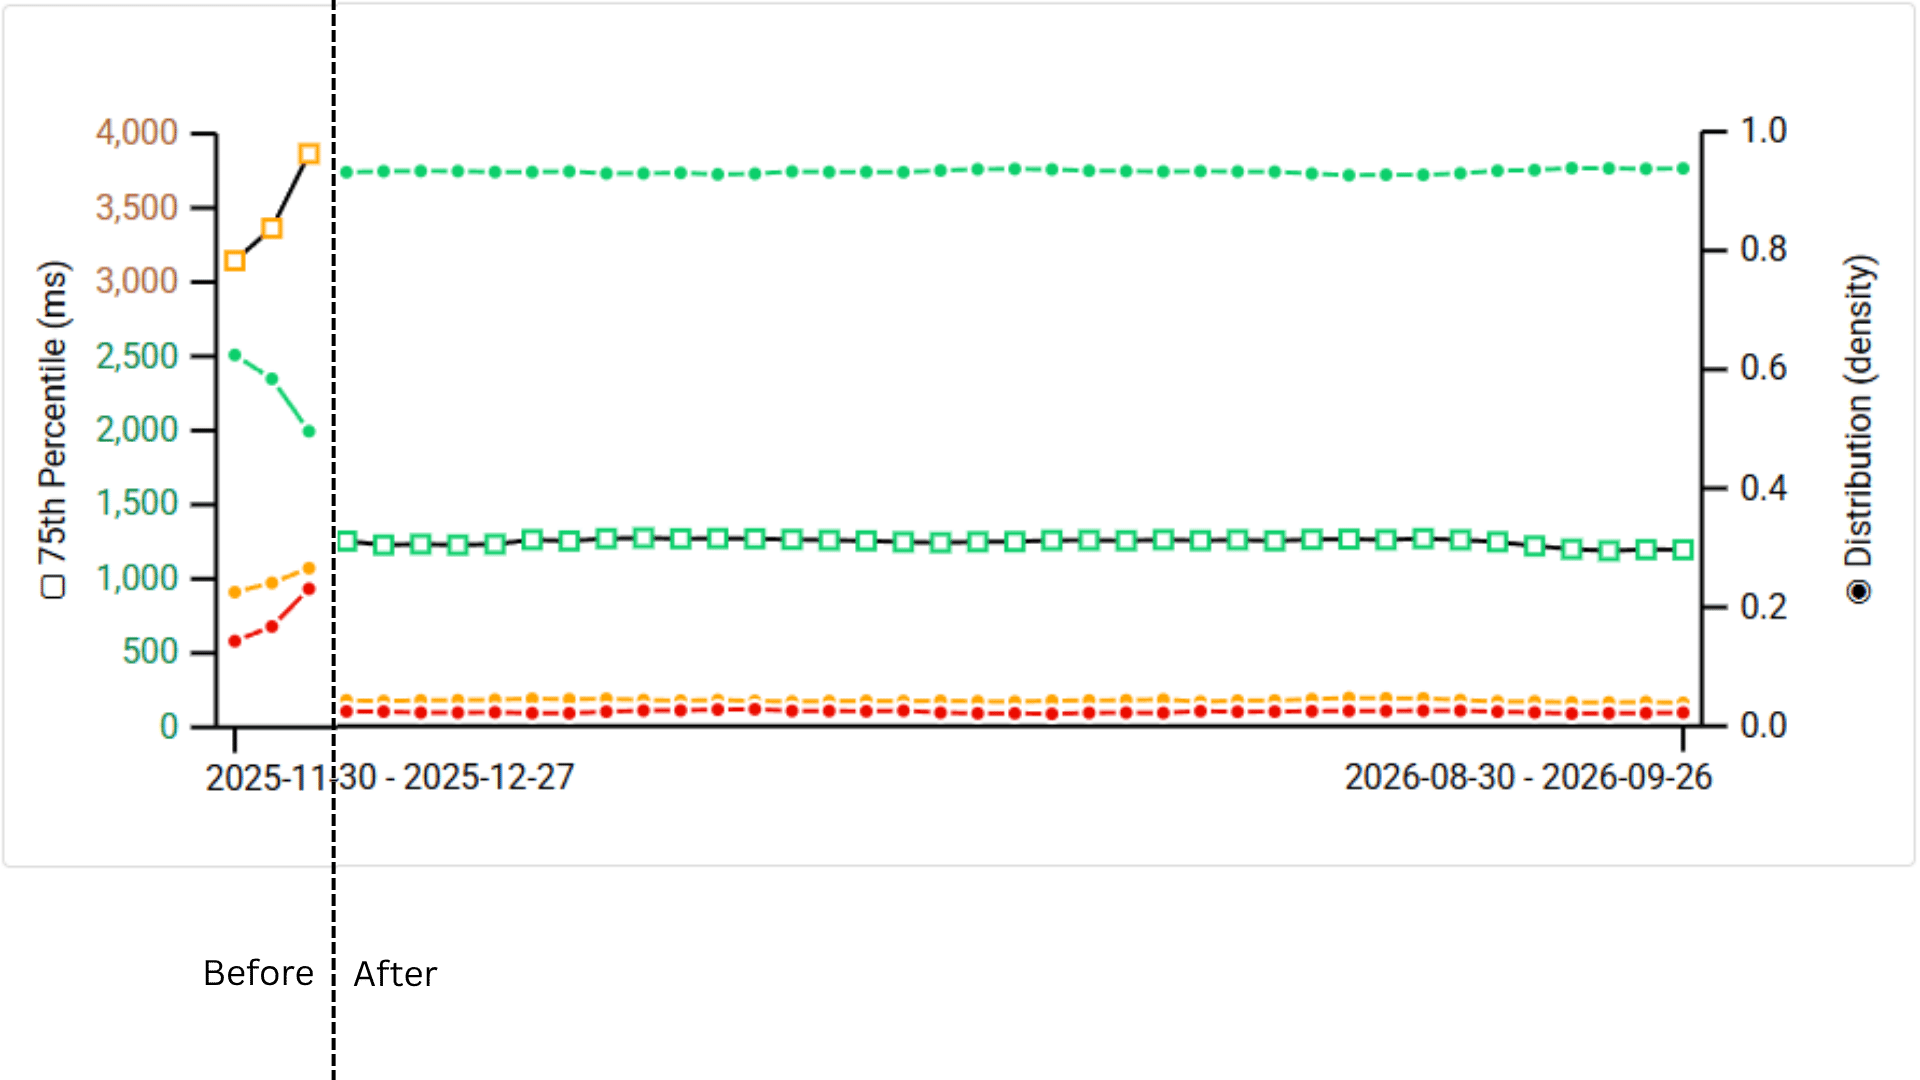
Und gerade beim LCP endet die Entwicklung nicht bei 1.219 ms: Die Langzeitkurve sinkt anschließend noch weiter.
Reaktion
TTFB: 1.636 ms → 285 ms
Die Time to First Byte zeigt am unmittelbarsten, was die Architektur auf der Serverseite verändert hat.
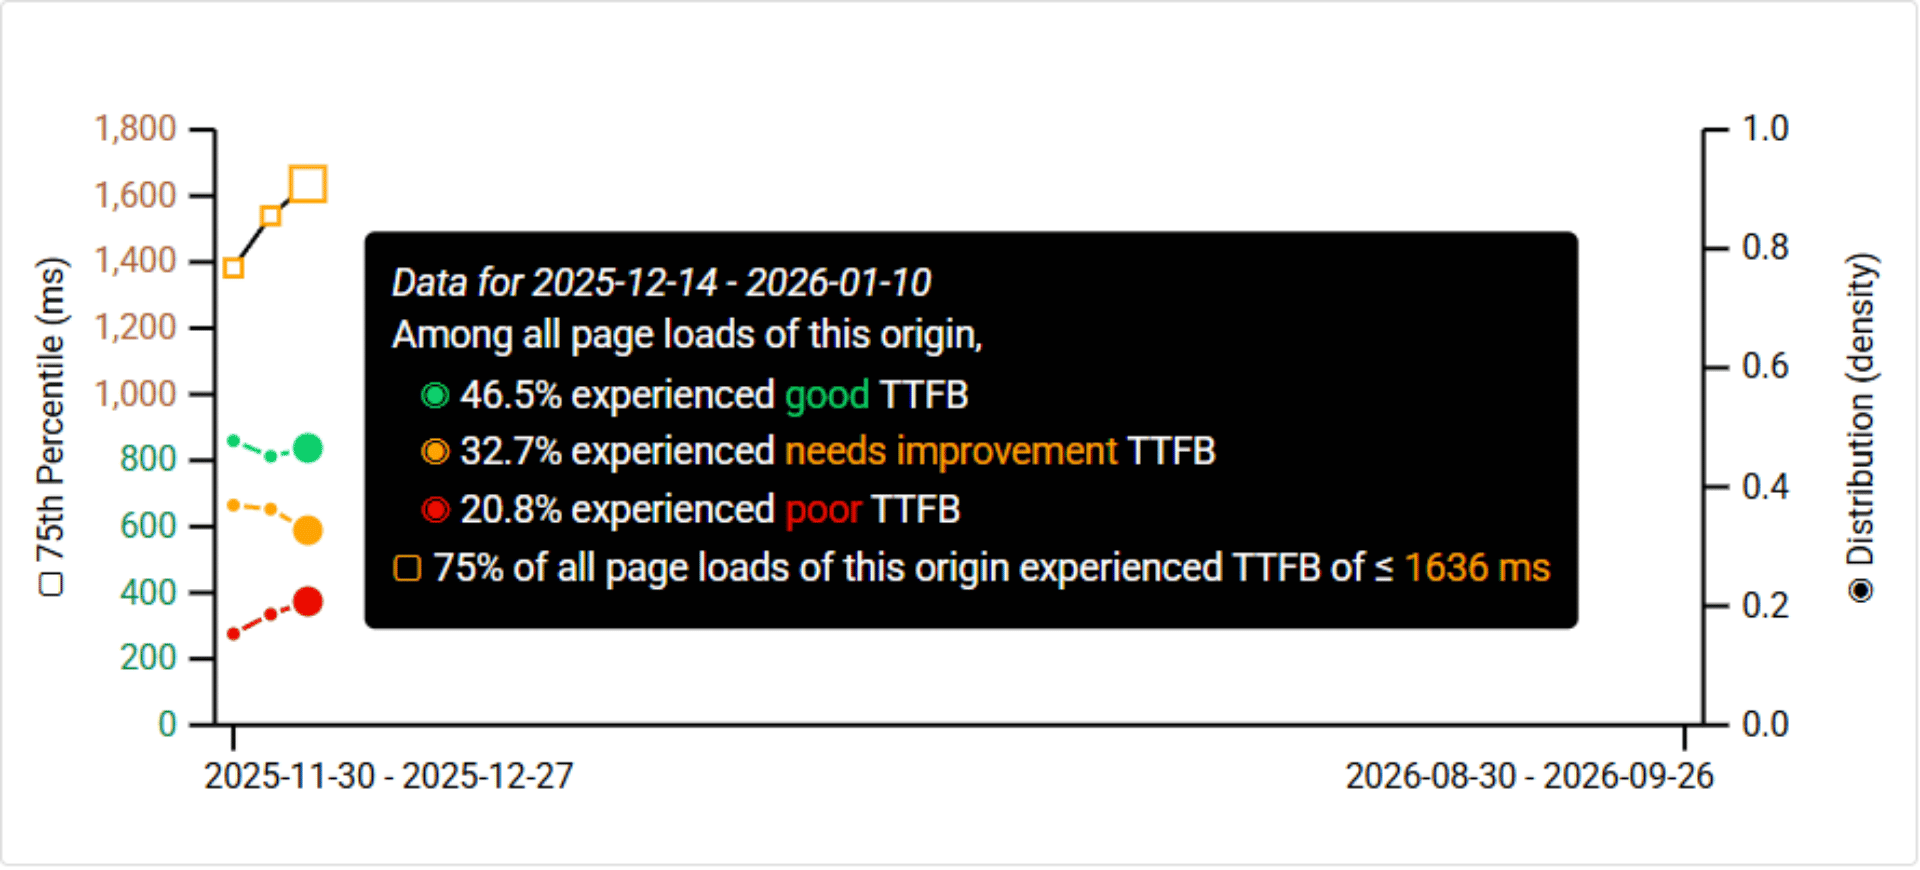
Vorher
- Good: 46,5 %
- Needs Improvement: 32,7 %
- Poor: 20,8 %
- TTFB p75: 1.636 ms
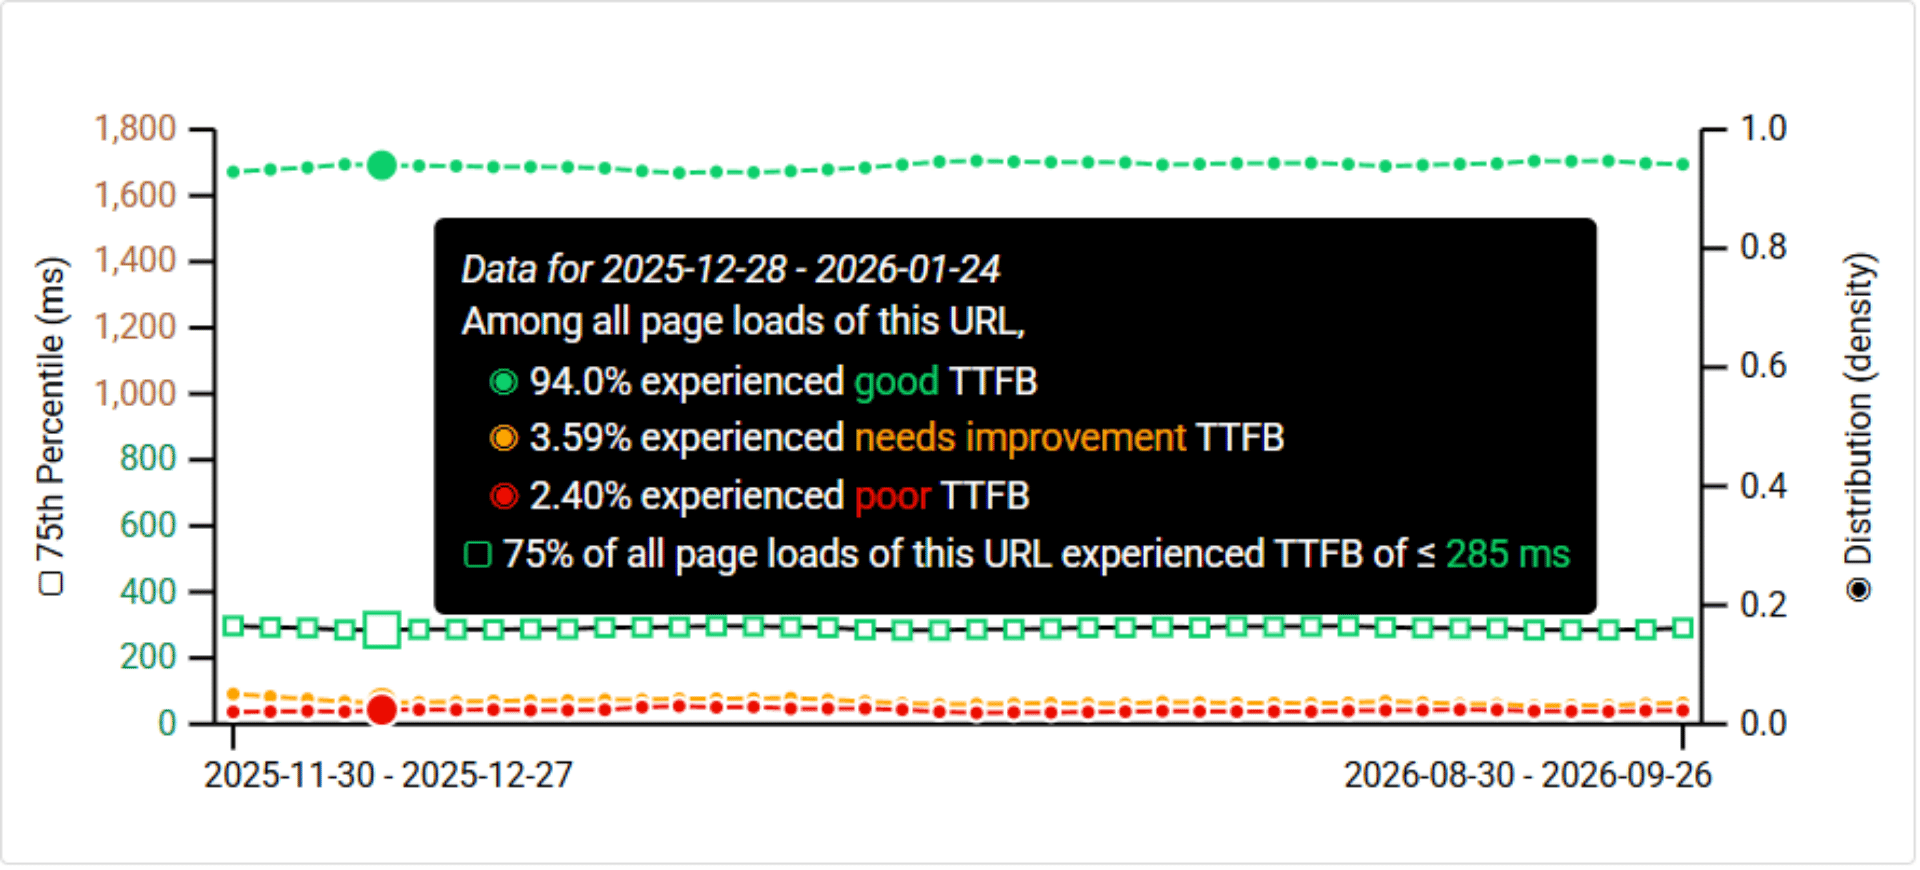
Nachher
- Good: 94,0 %
- Needs Improvement: 3,59 %
- Poor: 2,40 %
- TTFB p75: 285 ms
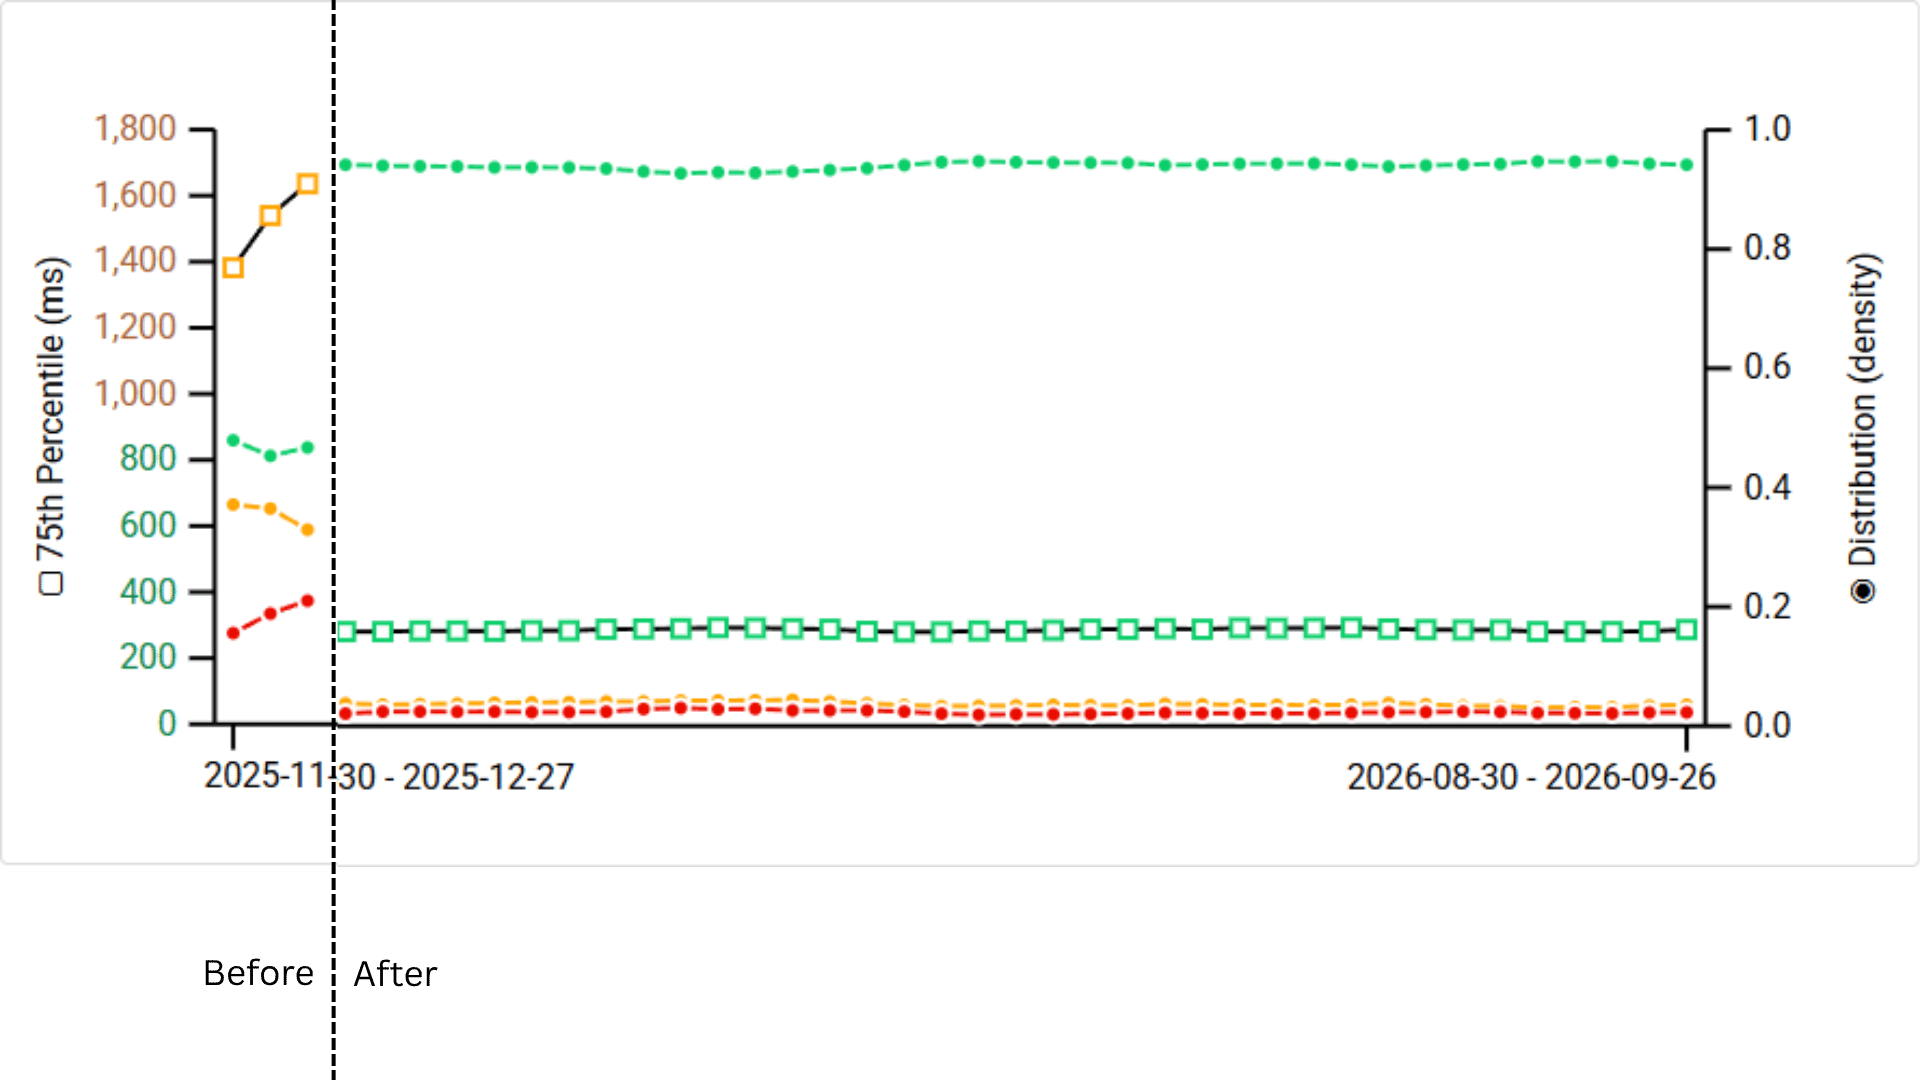
Damit sinkt die TTFB am 75. Perzentil um 82,6 %. Aus 1,636 Sekunden werden 285 Millisekunden.
Noch interessanter ist die Langzeitdarstellung: Der Wechsel ist als unmittelbarer Bruch sichtbar. Danach bleibt die TTFB über Monate auf einem sehr niedrigen Niveau.
Wartezeit
LCP: schneller trotz wachsendem System
Der Largest Contentful Paint ist für diese Case Study besonders interessant.
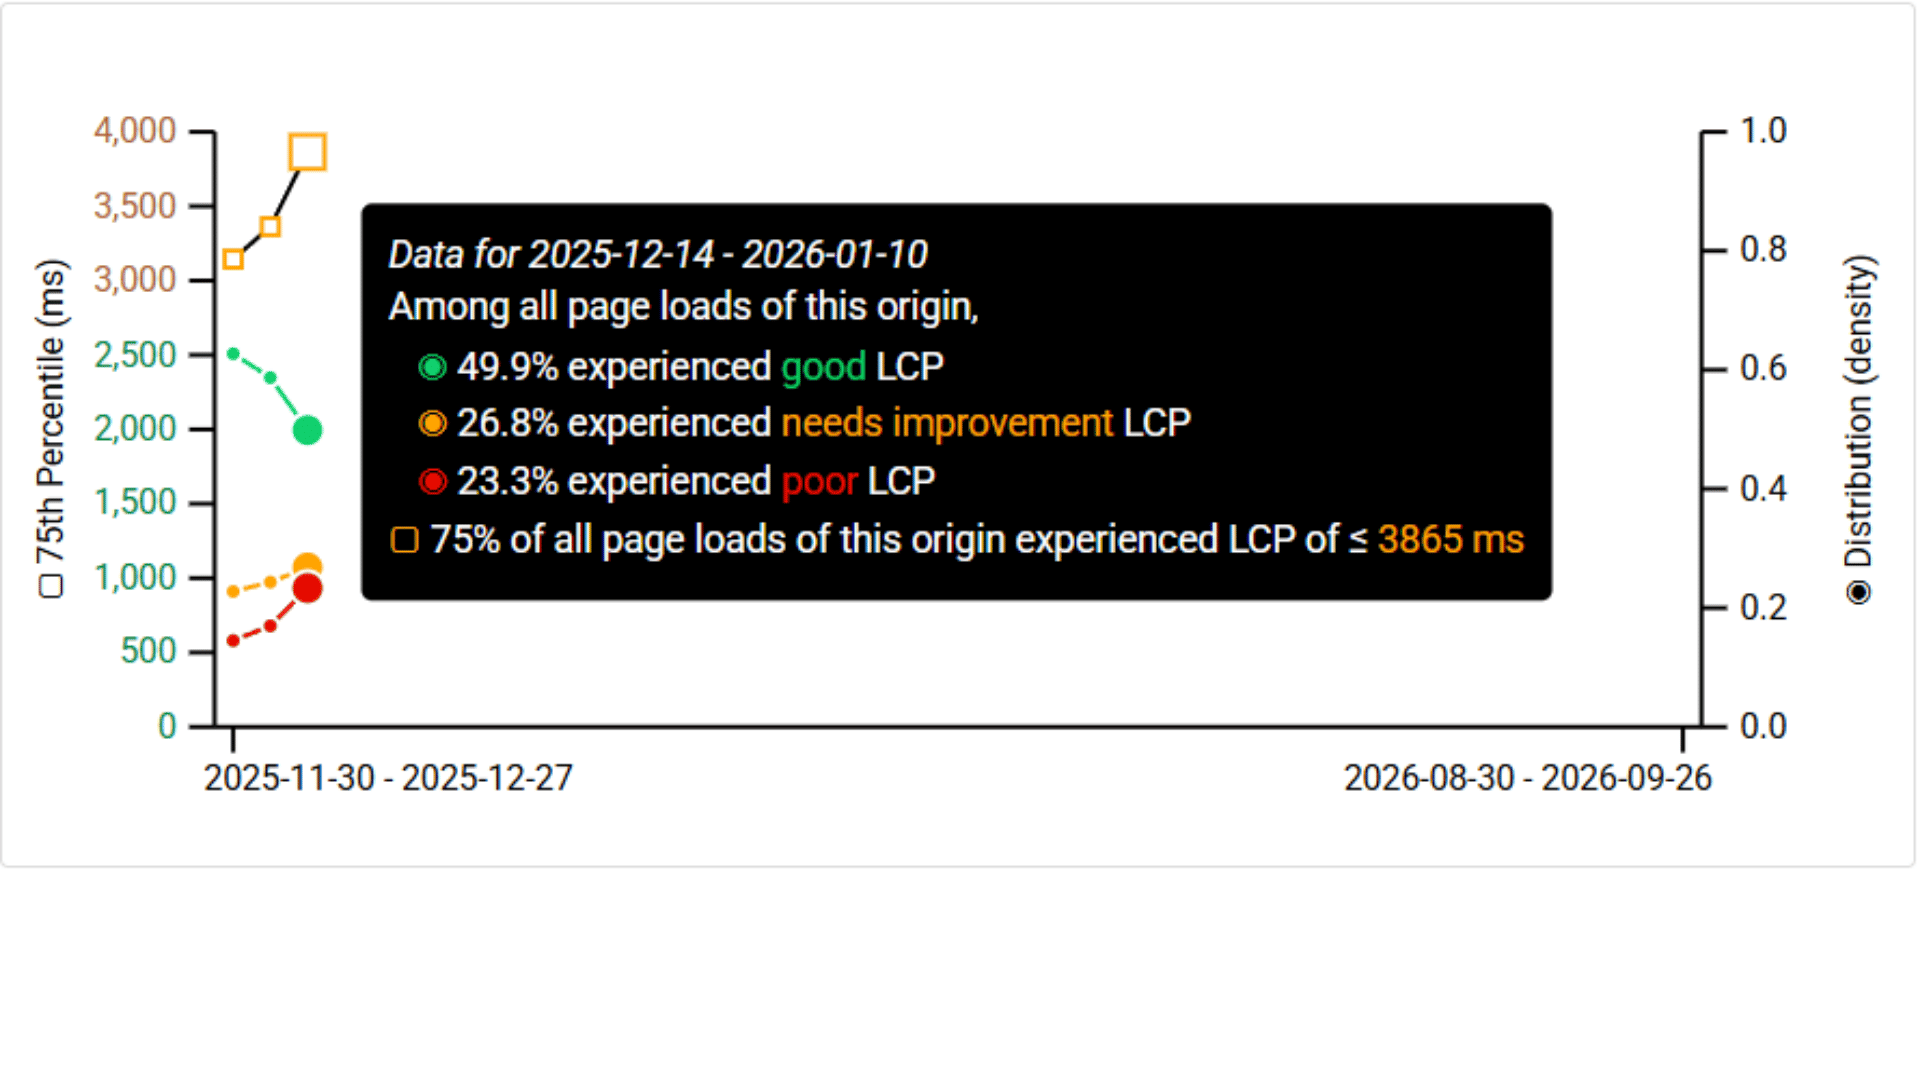
Vorher
- Good: 49,9 %
- Needs Improvement: 26,8 %
- Poor: 23,3 %
- LCP p75: 3.865 ms
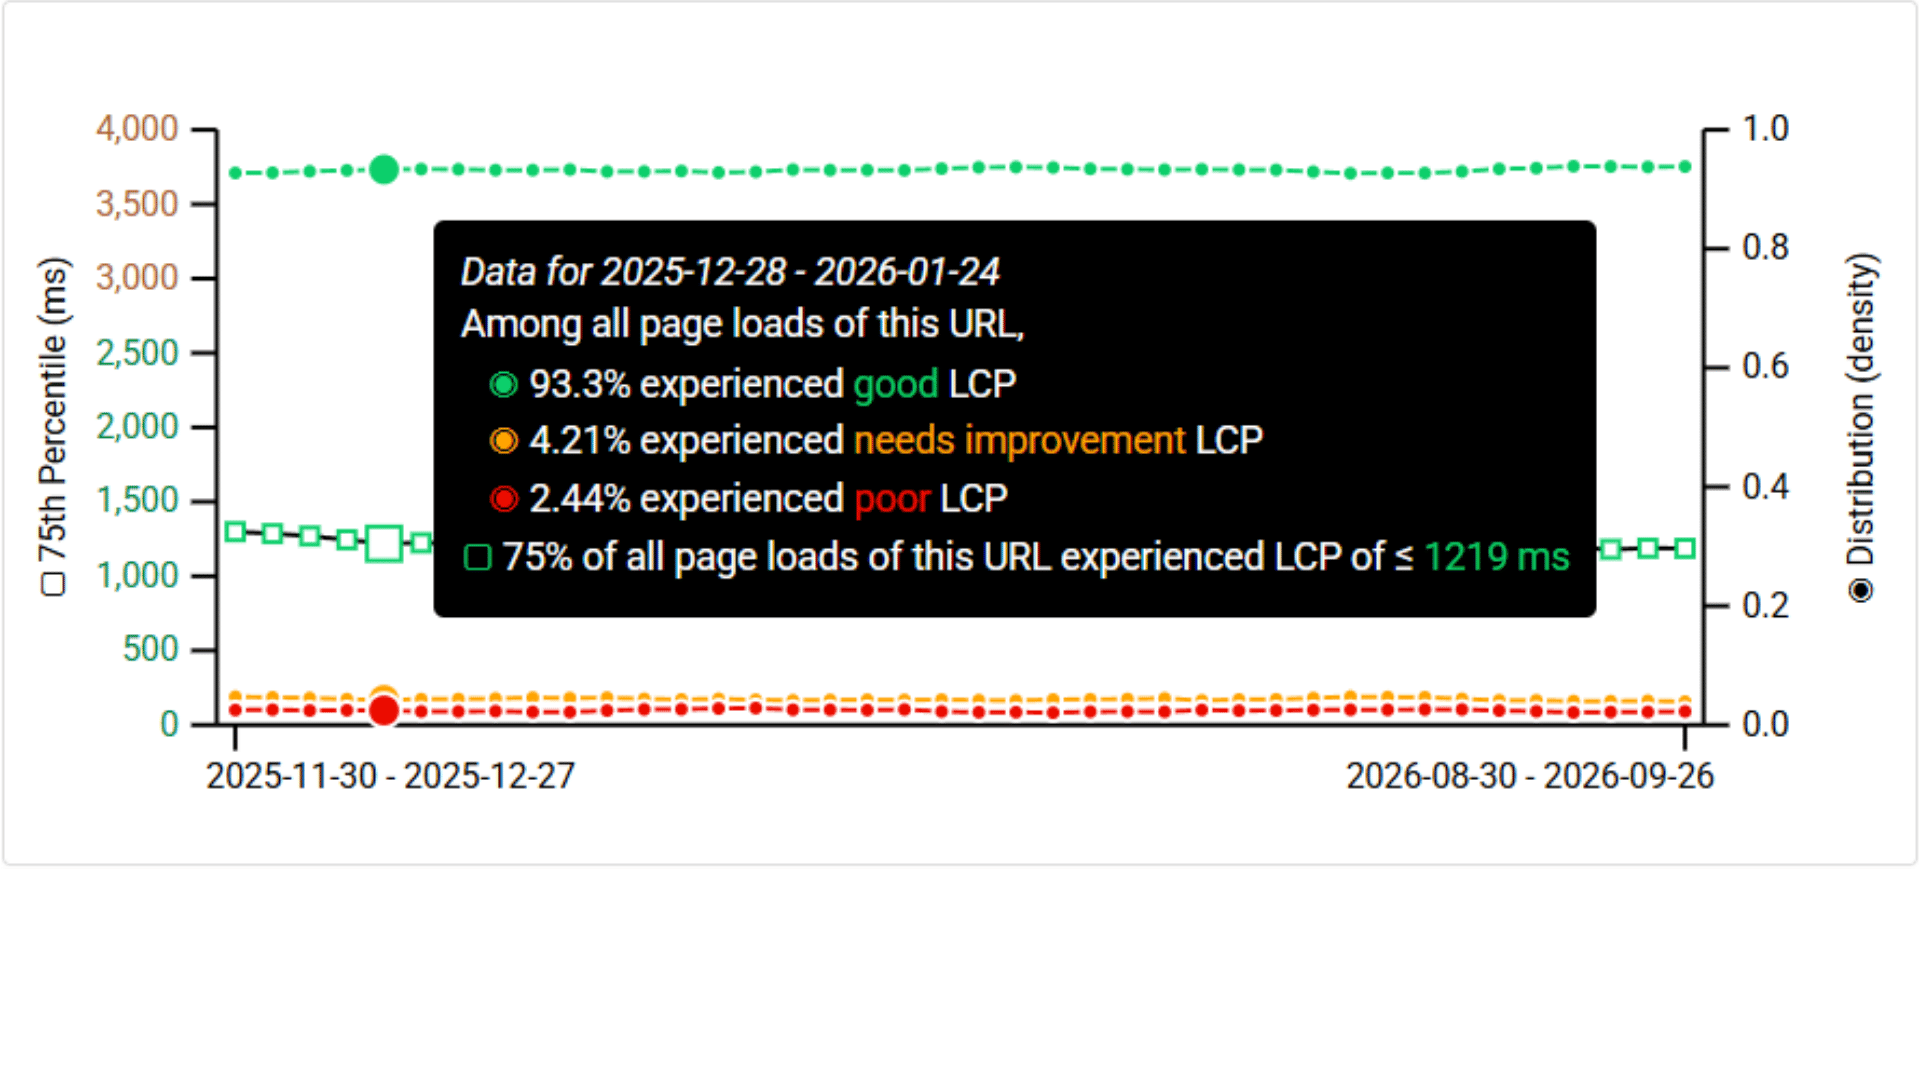
Nachher
Bereits kurz nach dem Architekturwechsel:
- Good: 93,3 %
- Needs Improvement: 4,21 %
- Poor: 2,44 %
- LCP p75: 1.219 ms
Das entspricht zunächst einer Verbesserung um 68,5 %. Doch genau hier wird die Langzeitentwicklung interessant. Der LCP springt nach der Migration nicht lediglich einmal auf einen besseren Wert und bleibt dort. Die Kurve fällt in den folgenden Monaten weiter. Währenddessen wächst OberpfalzECHO von etwa 76.000 auf fast 100.000 Artikel.
Das bedeutet:
Mehr als 24.000 zusätzliche Artikel, kontinuierliche redaktionelle Produktion – aber keine zunehmende Frontend-Latenz. Stattdessen verbessert sich der LCP weiter. Das Verhalten passt zum Grundprinzip der VeloCore-Architektur: Der öffentlich sichtbare Request-Pfad hängt nicht mehr direkt von der Größe und Komplexität der WordPress-Datenbank ab.
Performance
Core Web Vitals: kompletter Wechsel in den grünen Bereich
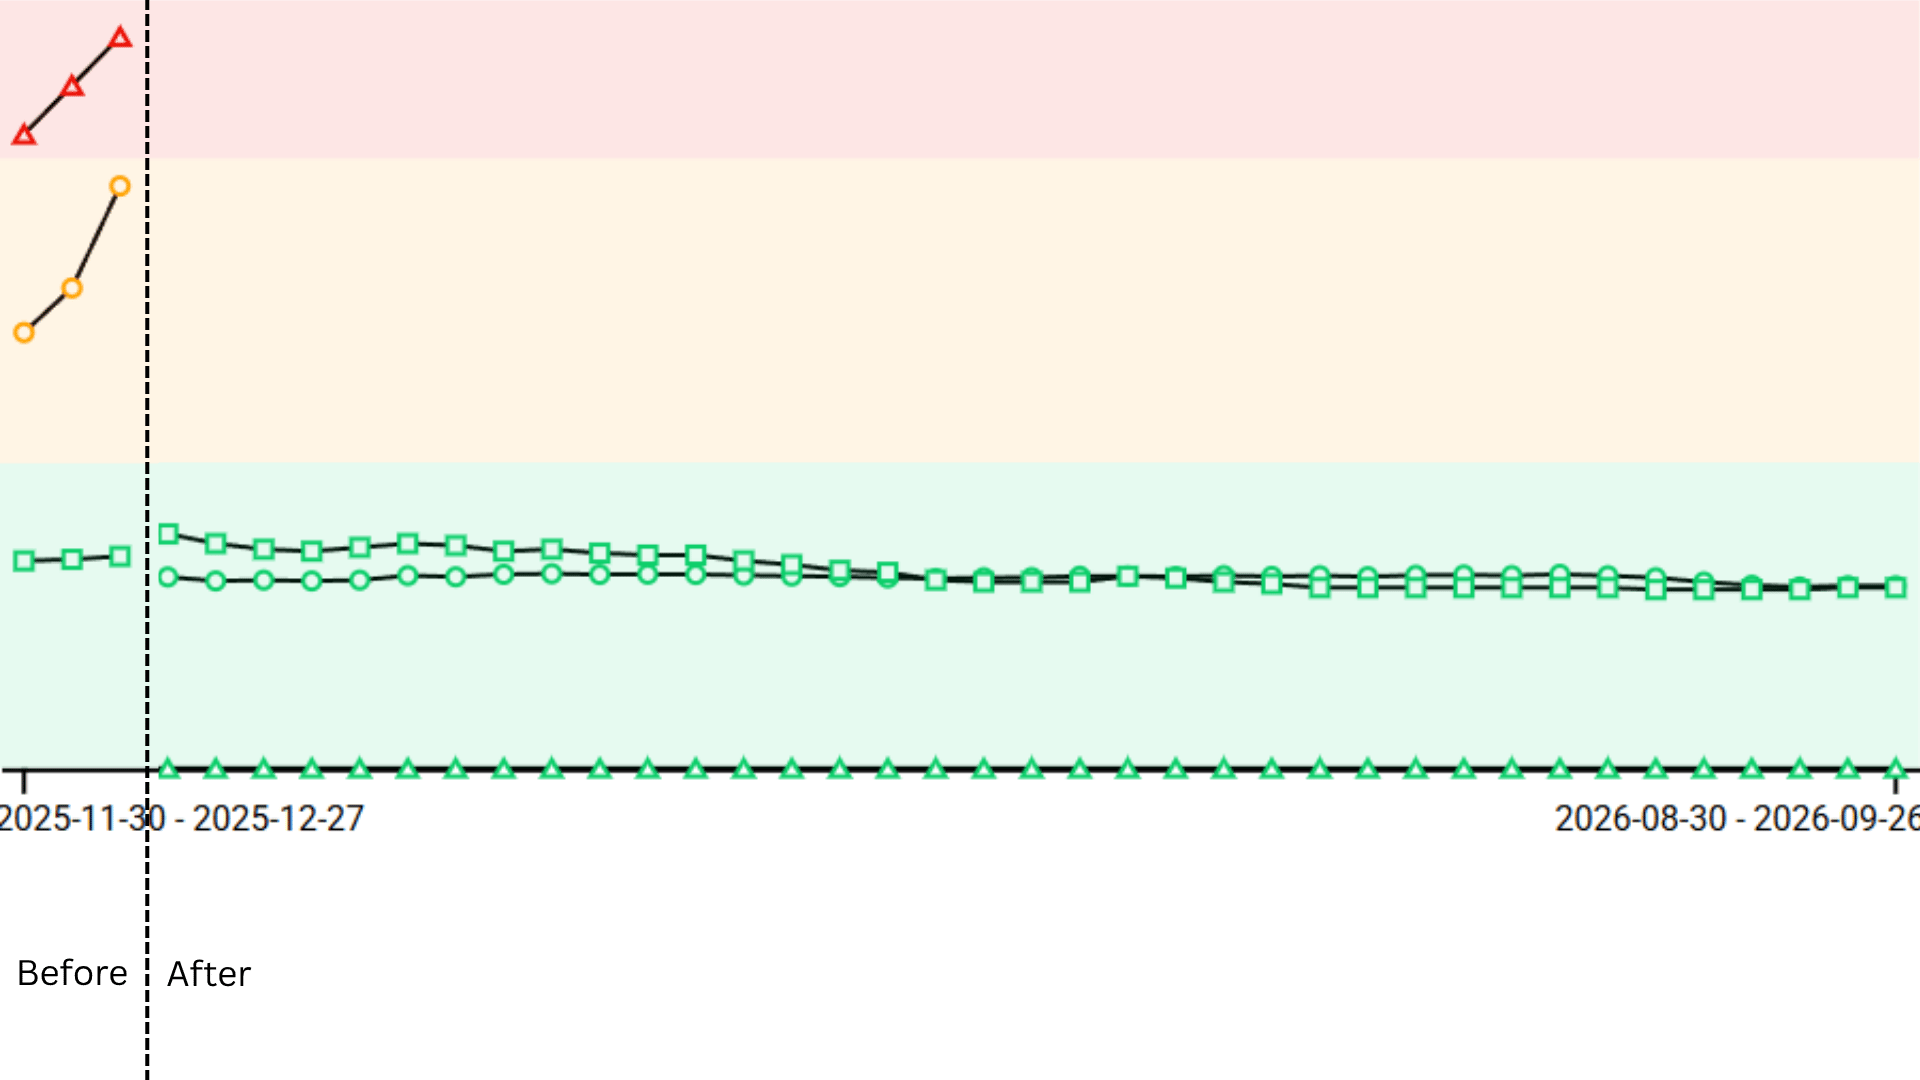
Die kombinierte Core-Web-Vitals-Ansicht zeigt den Architekturwechsel besonders kompakt.
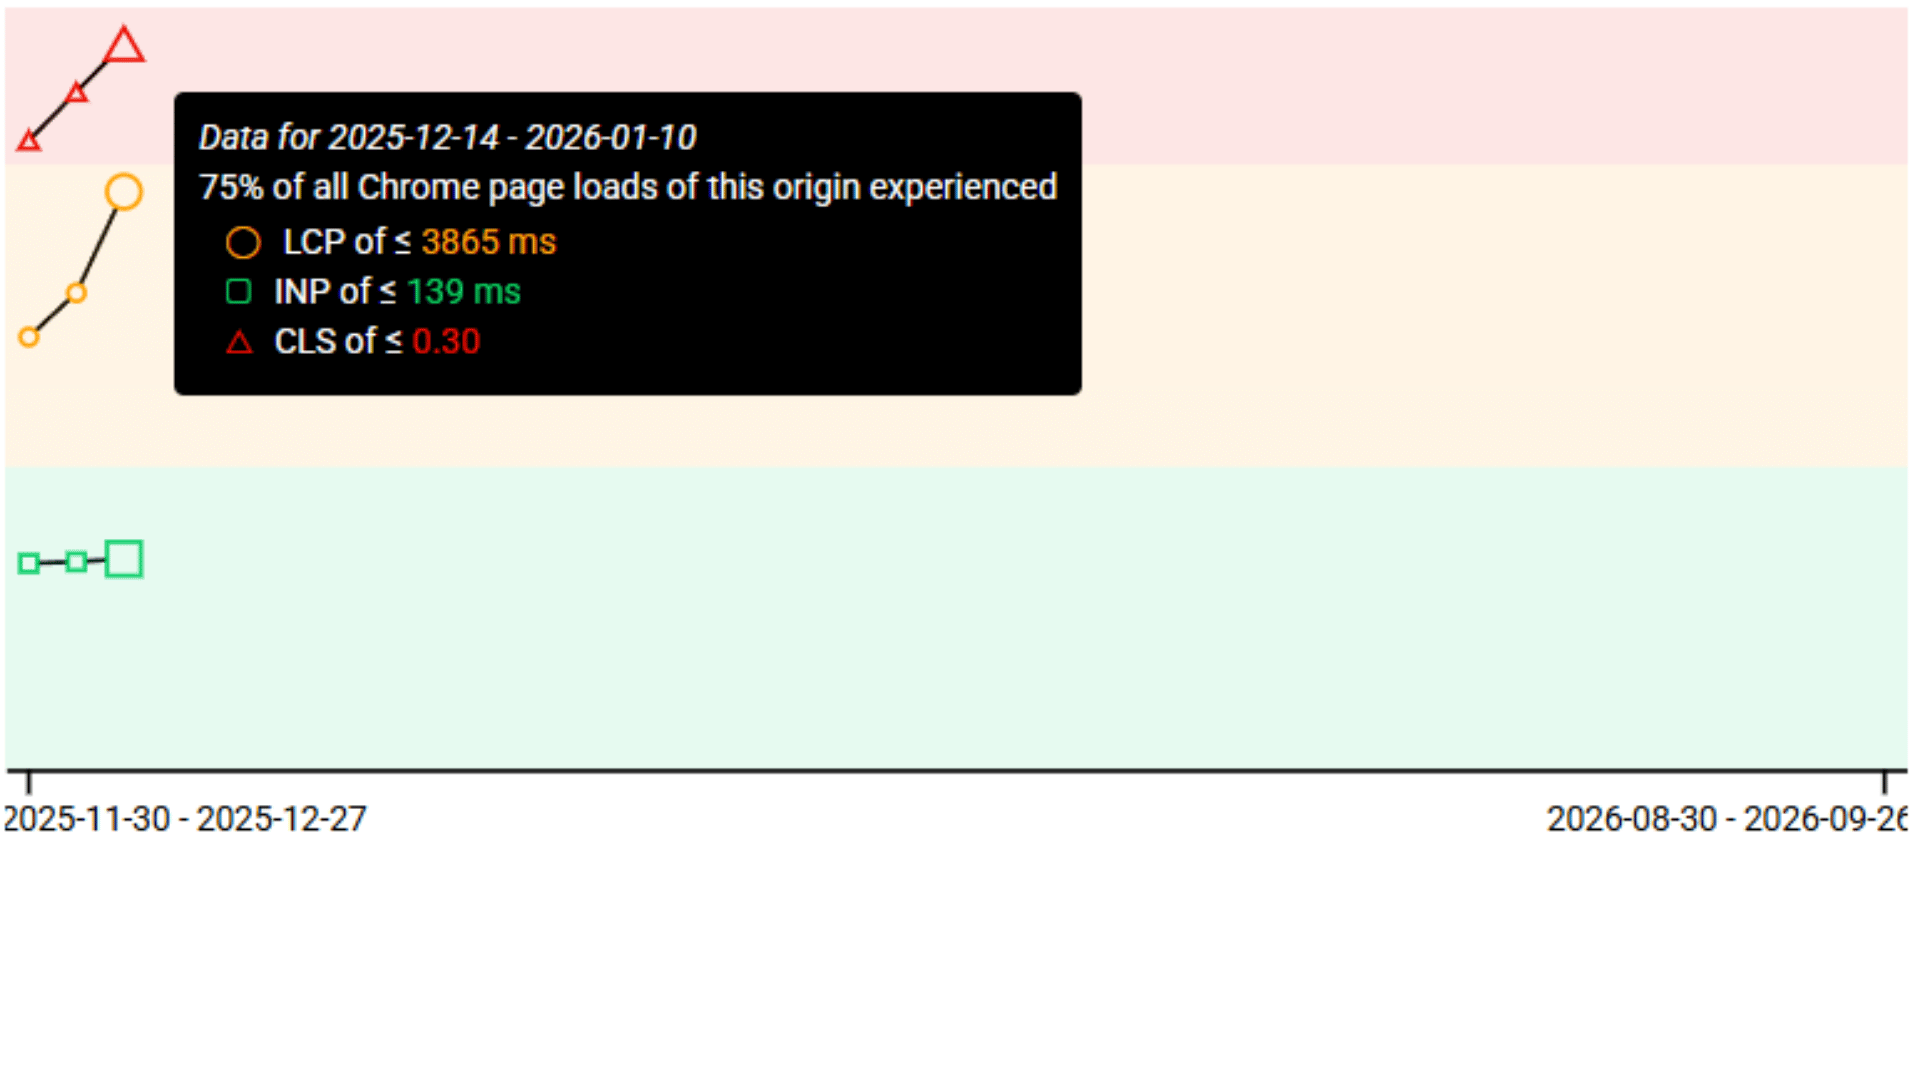
Vorher
- LCP: 3.865 ms
- INP: 139 ms
- CLS: 0,30
Vor allem LCP und CLS lagen damit deutlich außerhalb eines optimalen Bereichs.
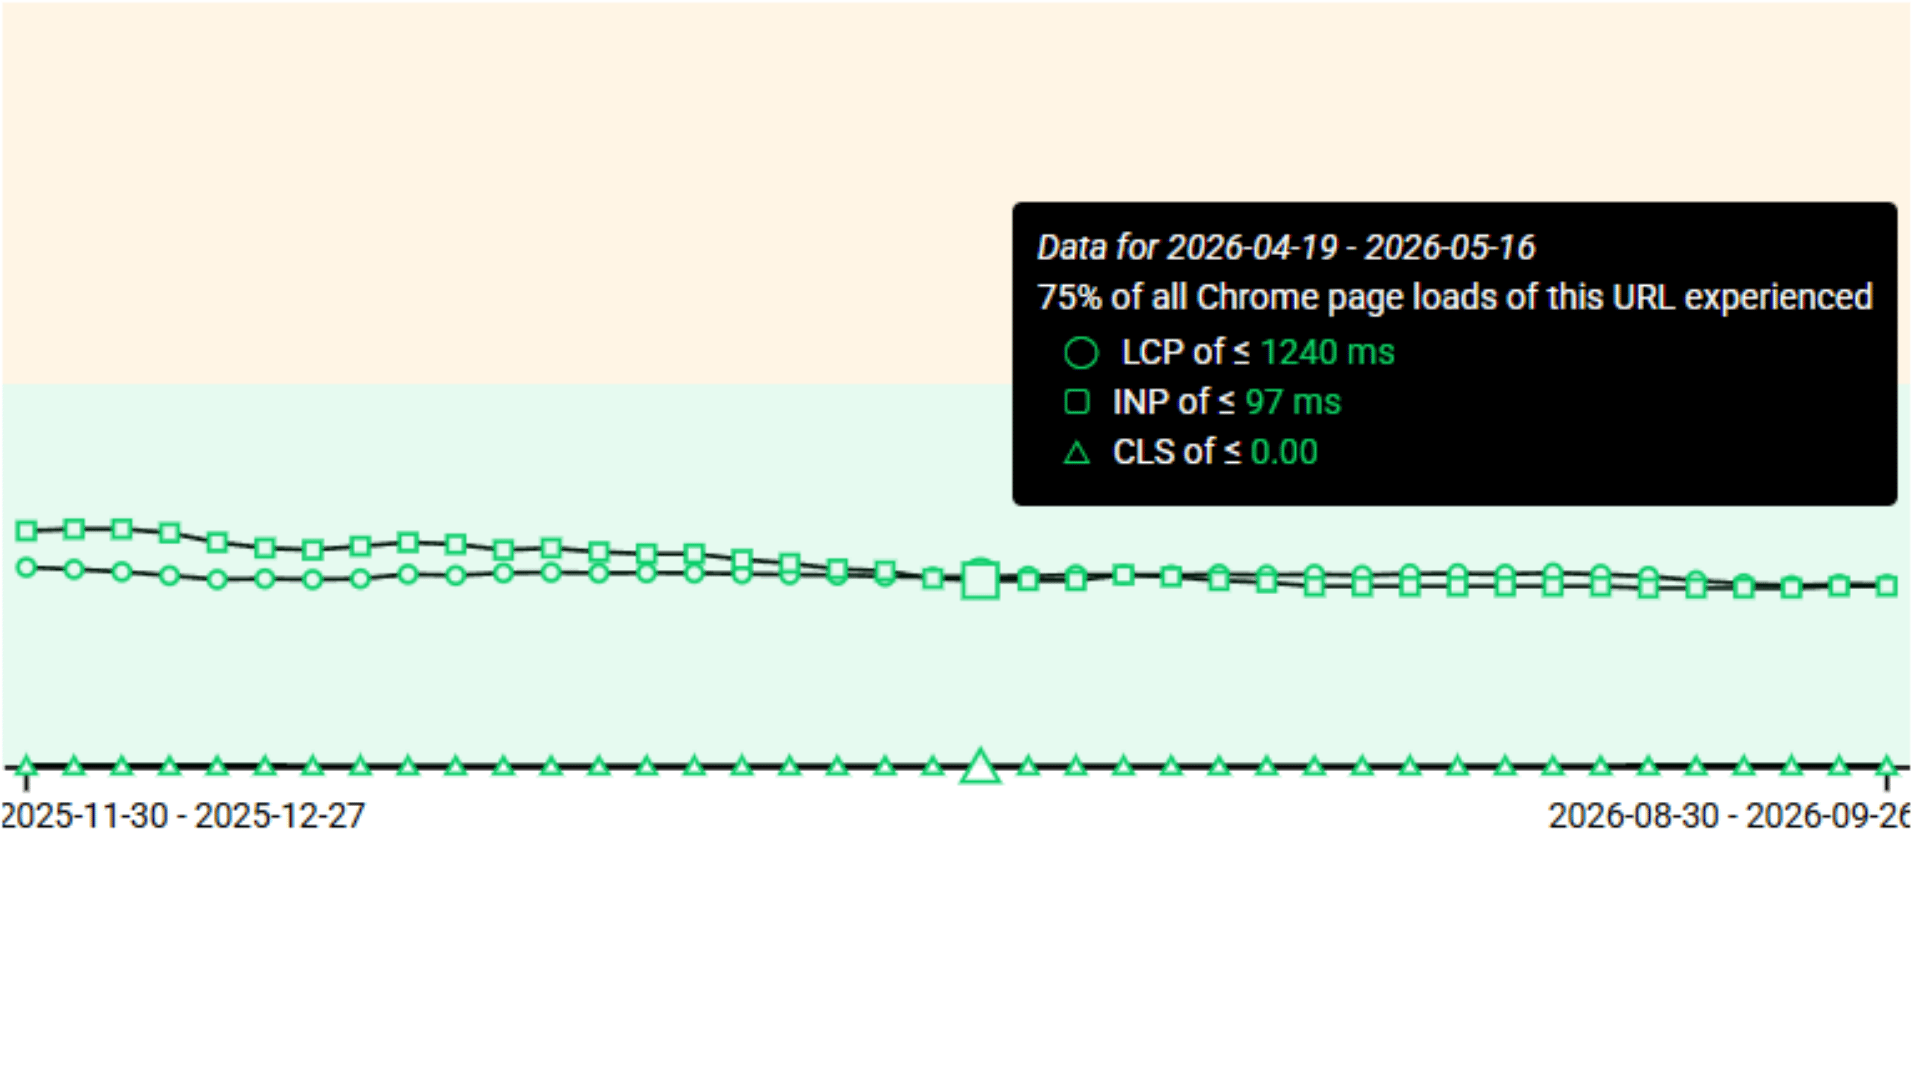
Nachher
- LCP: 1.240 ms
- INP: 97 ms
- CLS: 0,00
Alle drei Core Web Vitals liegen anschließend gleichzeitig im grünen Bereich.
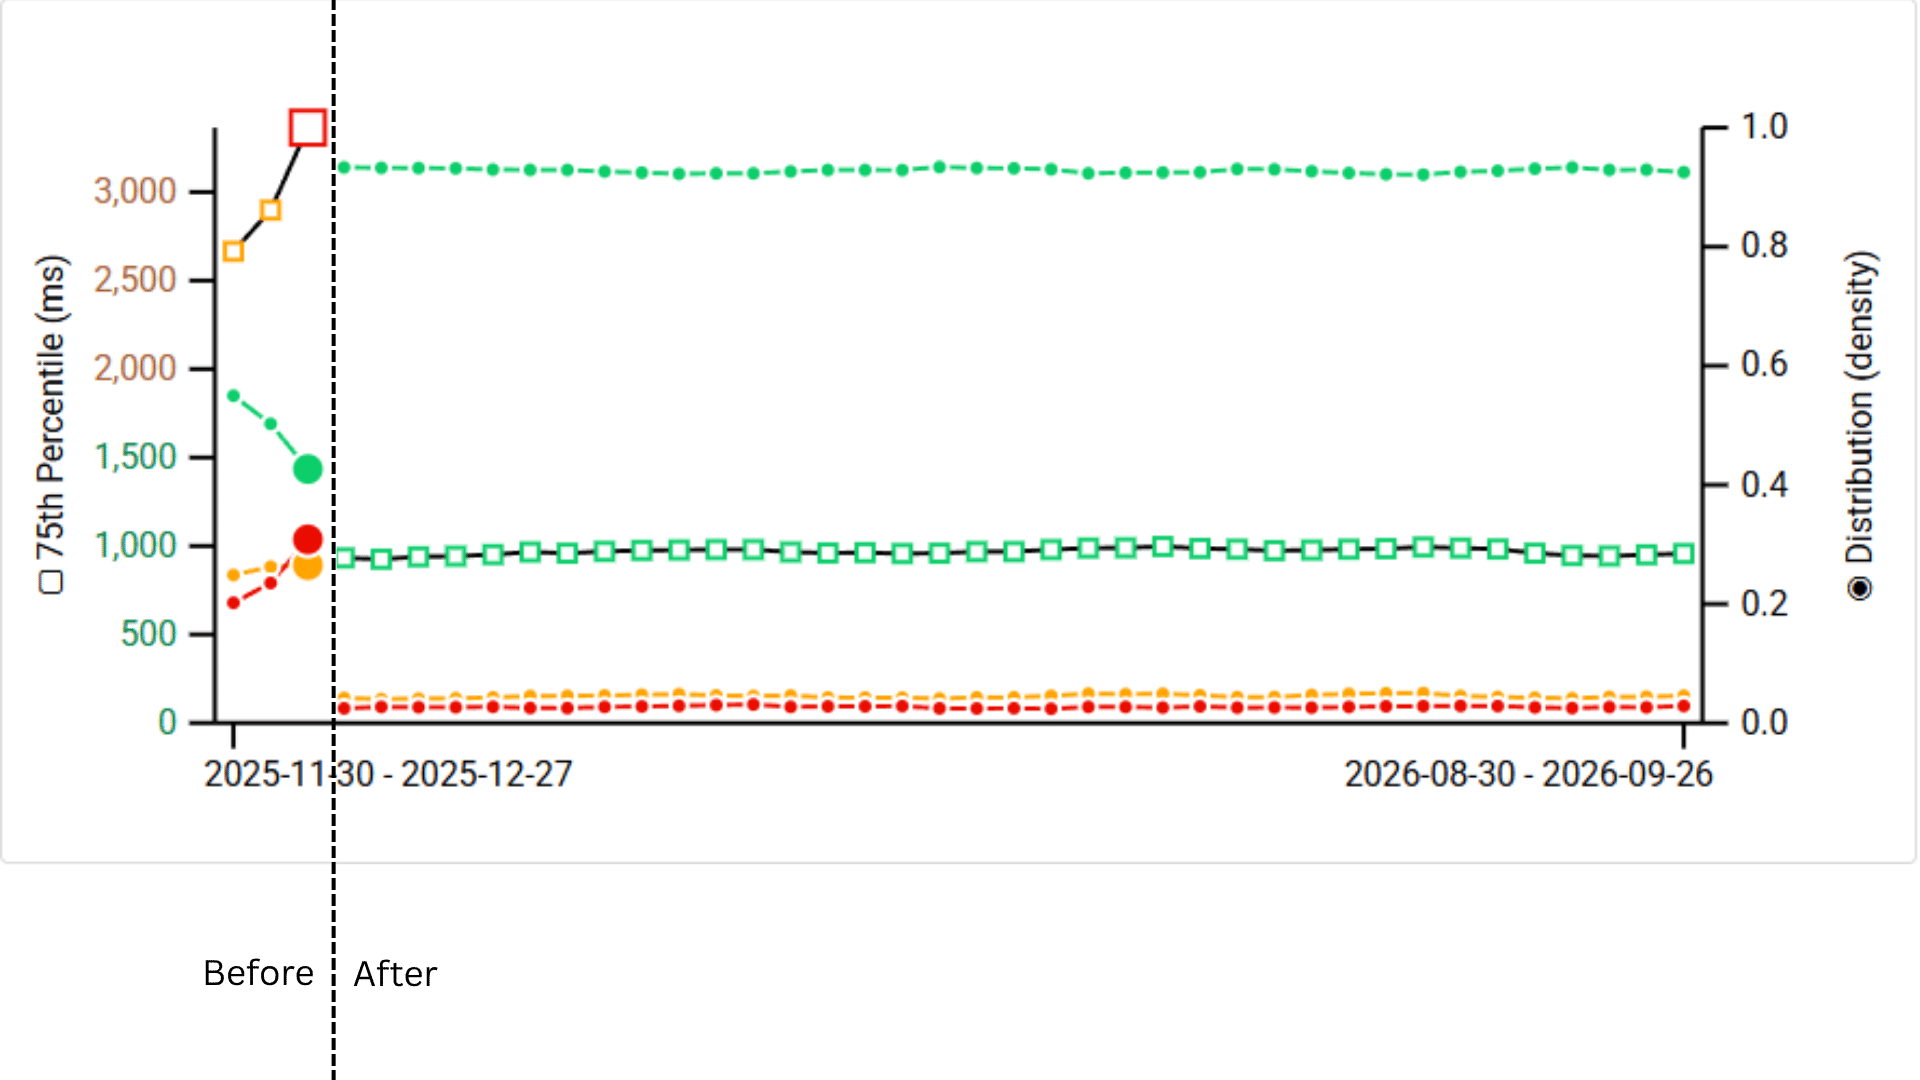
Die Zeitreihe zeigt erneut einen ausgesprochen klaren Übergang. Besonders auffällig: Der Wechsel findet nicht langsam über zahlreiche Optimierungsschritte statt. Die Kennzahlen ändern ihr Niveau unmittelbar am Architektur-Cutover.
FCP: 3.364 ms → 838 ms
Auch der First Contentful Paint zeigt einen deutlichen Sprung.
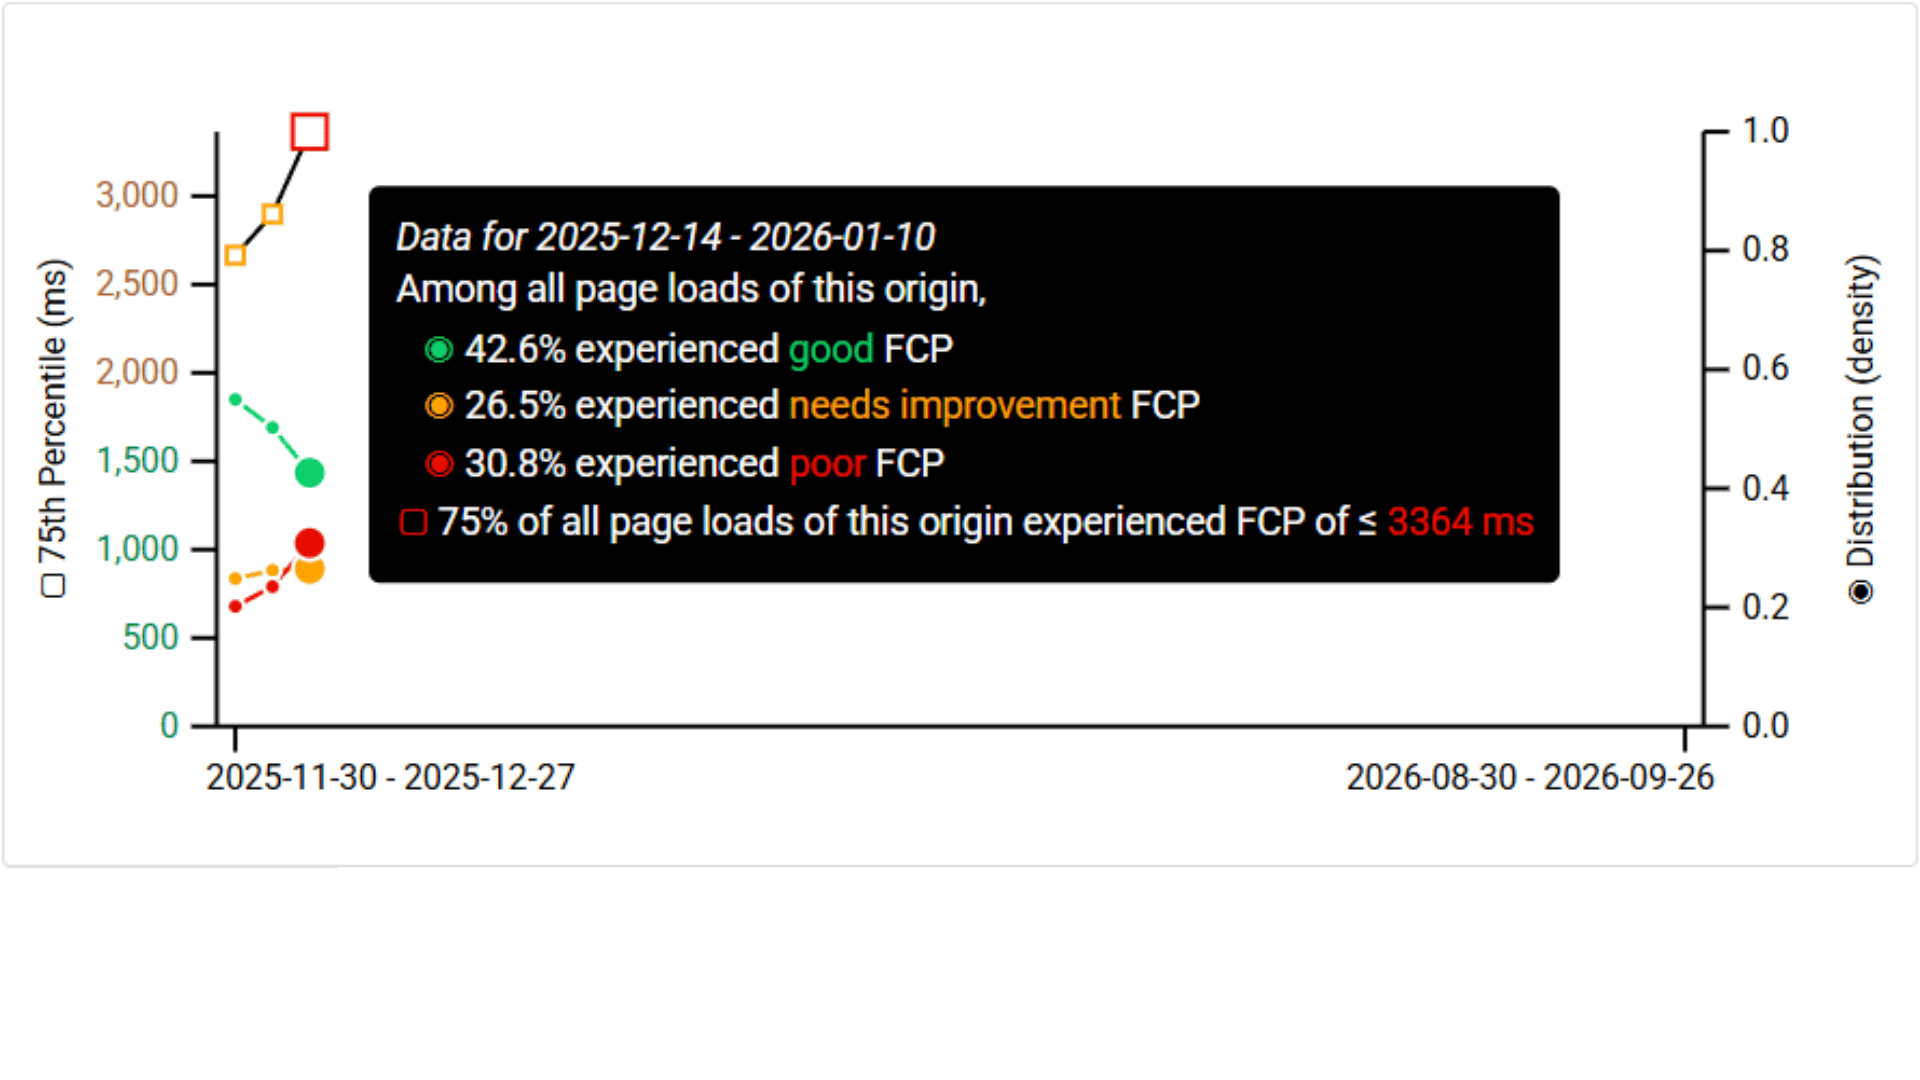
Vorher
- Good: 42,6 %
- Needs Improvement: 26,5 %
- Poor: 30,8 %
- FCP p75: 3.364 ms
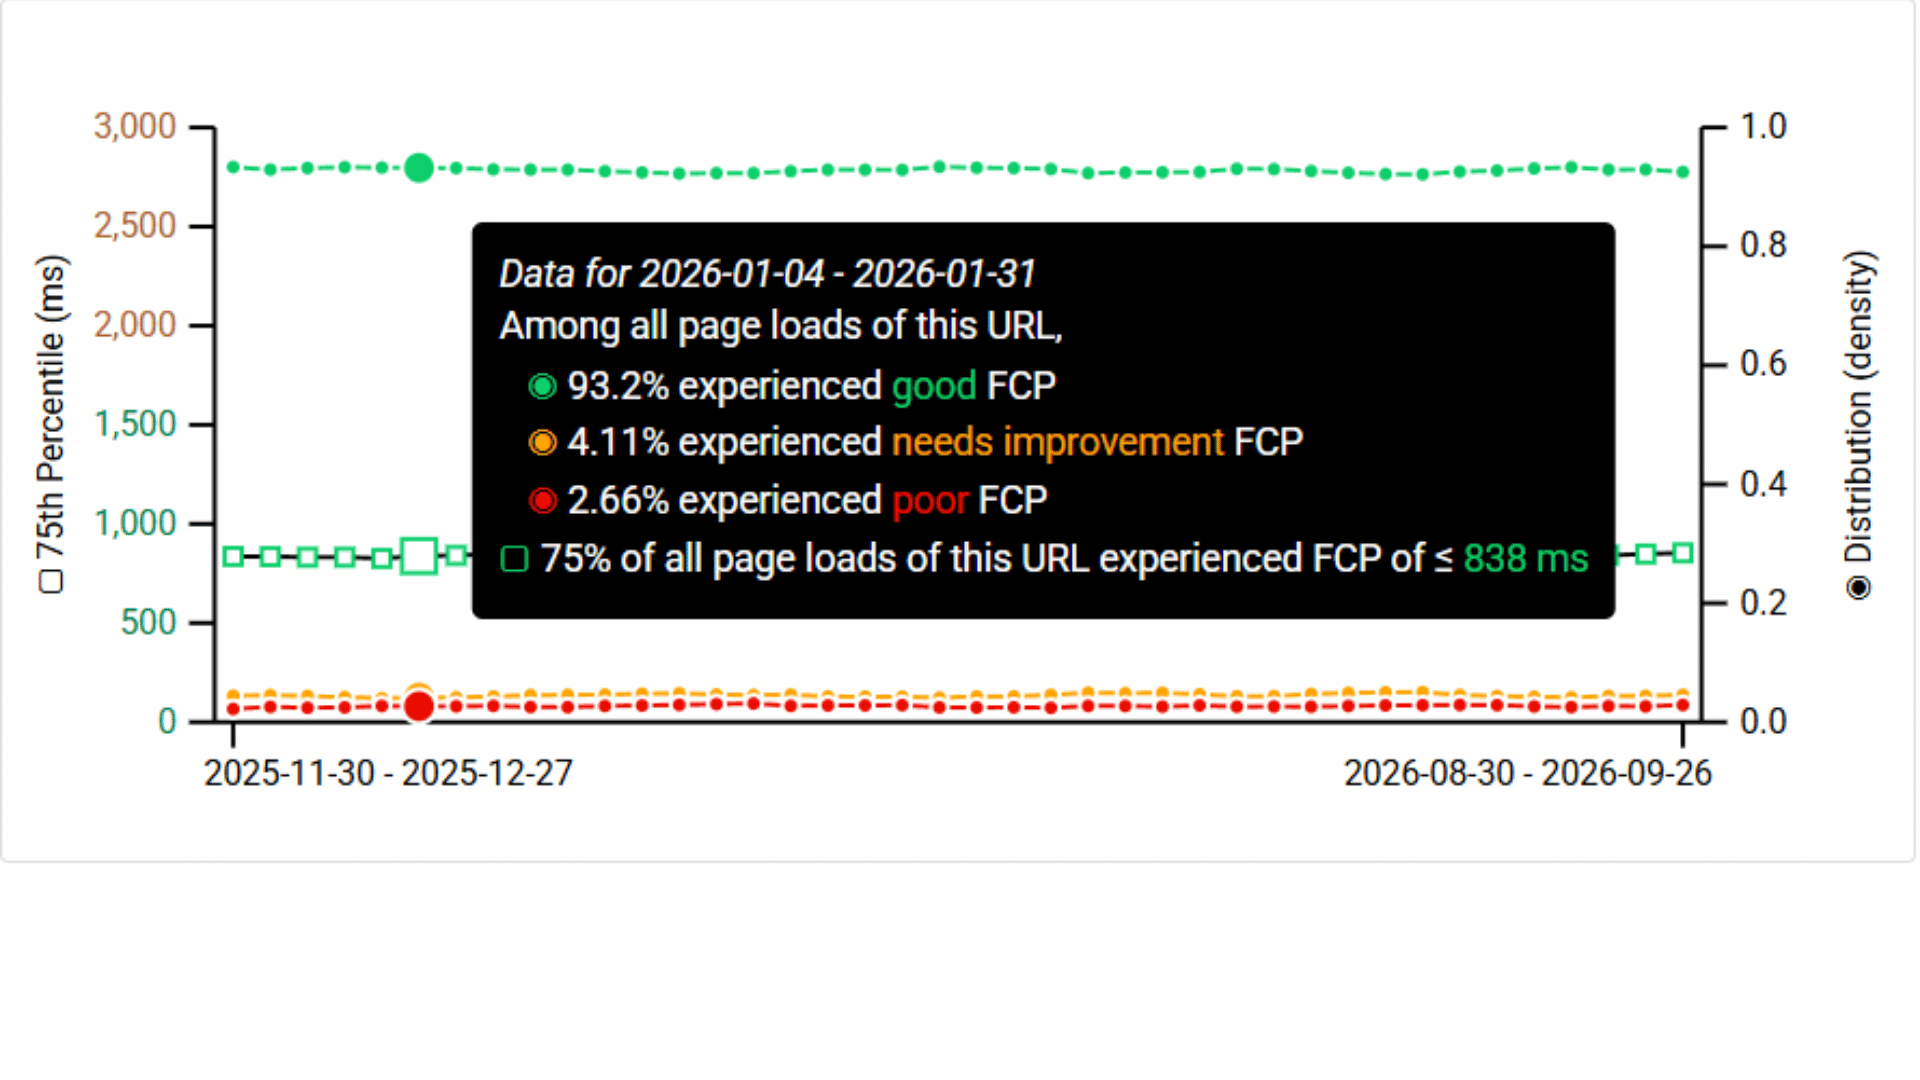
Nachher
- Good: 93,2 %
- Needs Improvement: 4,11 %
- Poor: 2,66 %
- FCP p75: 838 ms
Der FCP wird damit um 75,1 % reduziert. Gleichzeitig steigt der Anteil guter Nutzererfahrungen von 42,6 % auf 93,2 %. Das sind +50,6 Prozentpunkte. Auch hier bleibt das neue Niveau nach der Migration über die weitere Messperiode stabil.
CLS: 0,30 → 0,00
Die Veränderung beim Cumulative Layout Shift ist besonders deutlich.
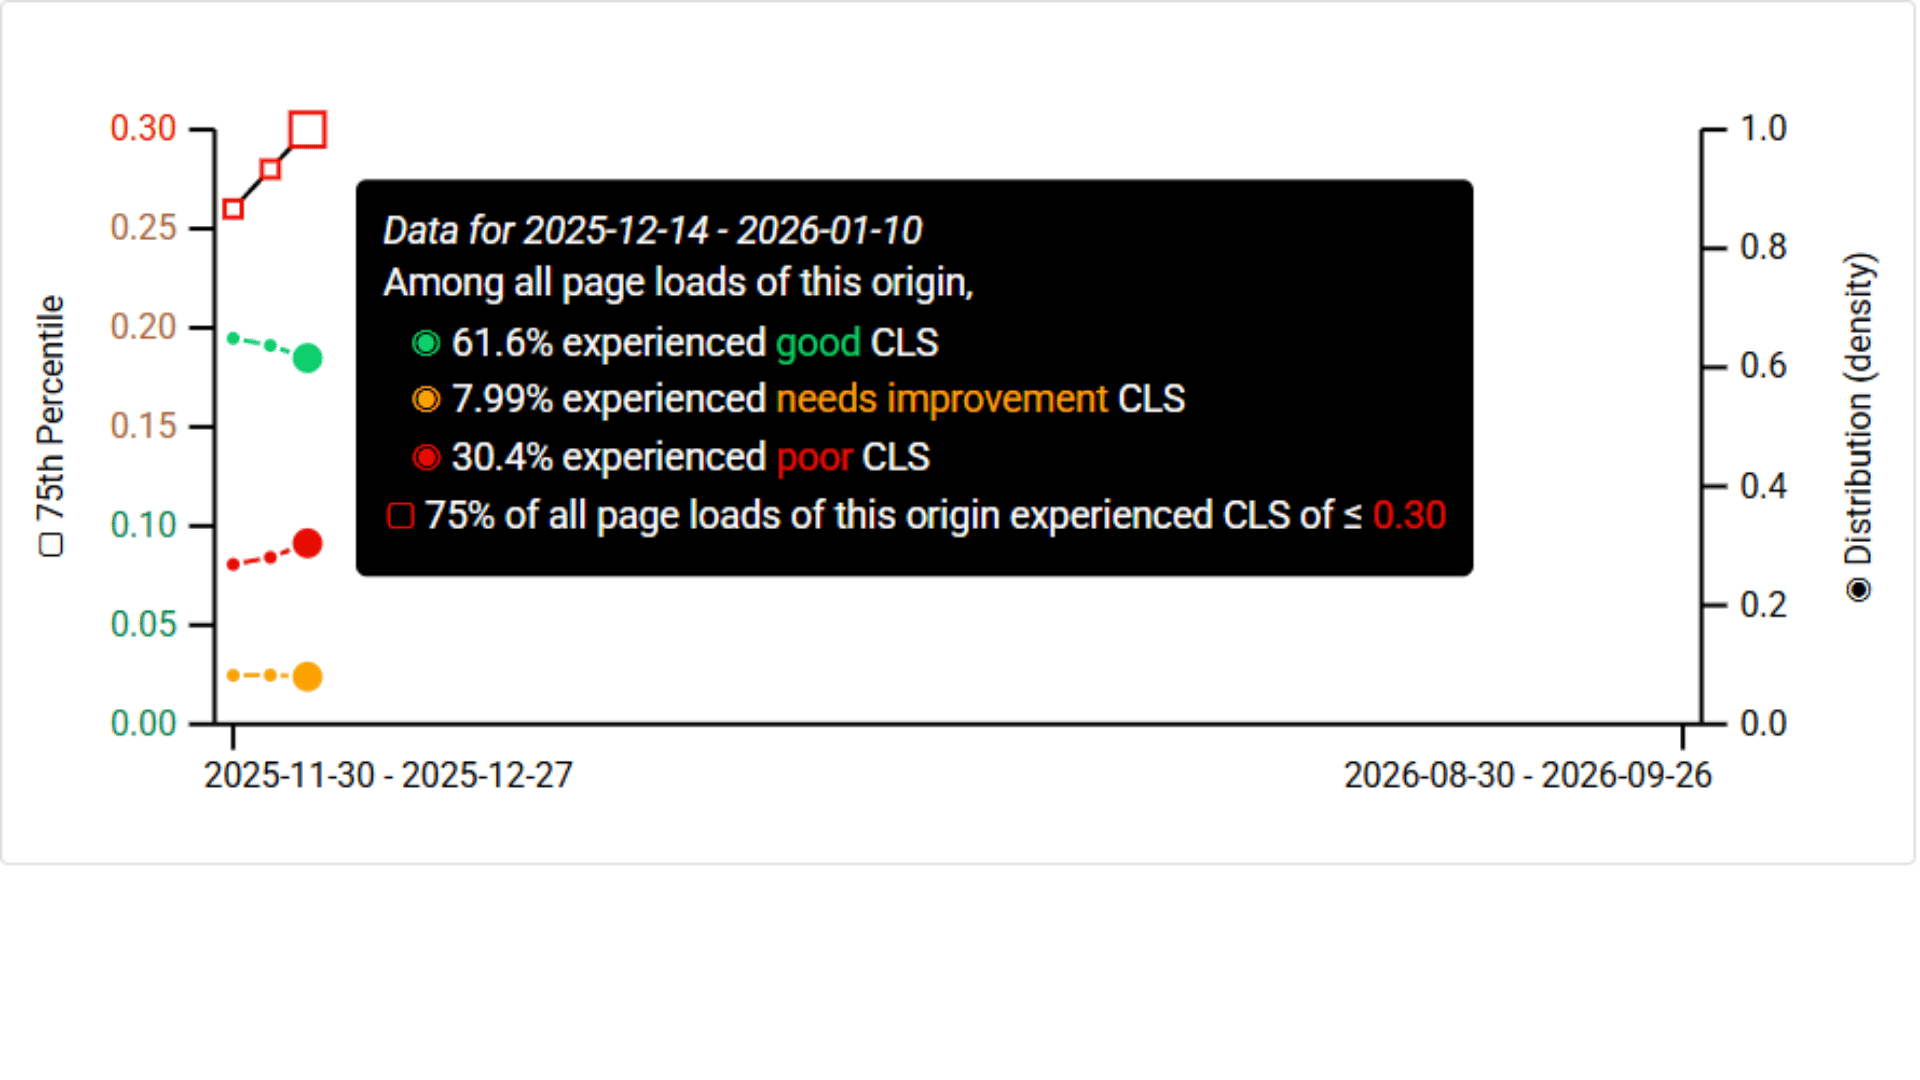
Vorher
- Good: 61,6 %
- Needs Improvement: 7,99 %
- Poor: 30,4 %
- CLS p75: 0,30
Fast jeder dritte gemessene Seitenaufruf lag damit im schlechten Bereich.
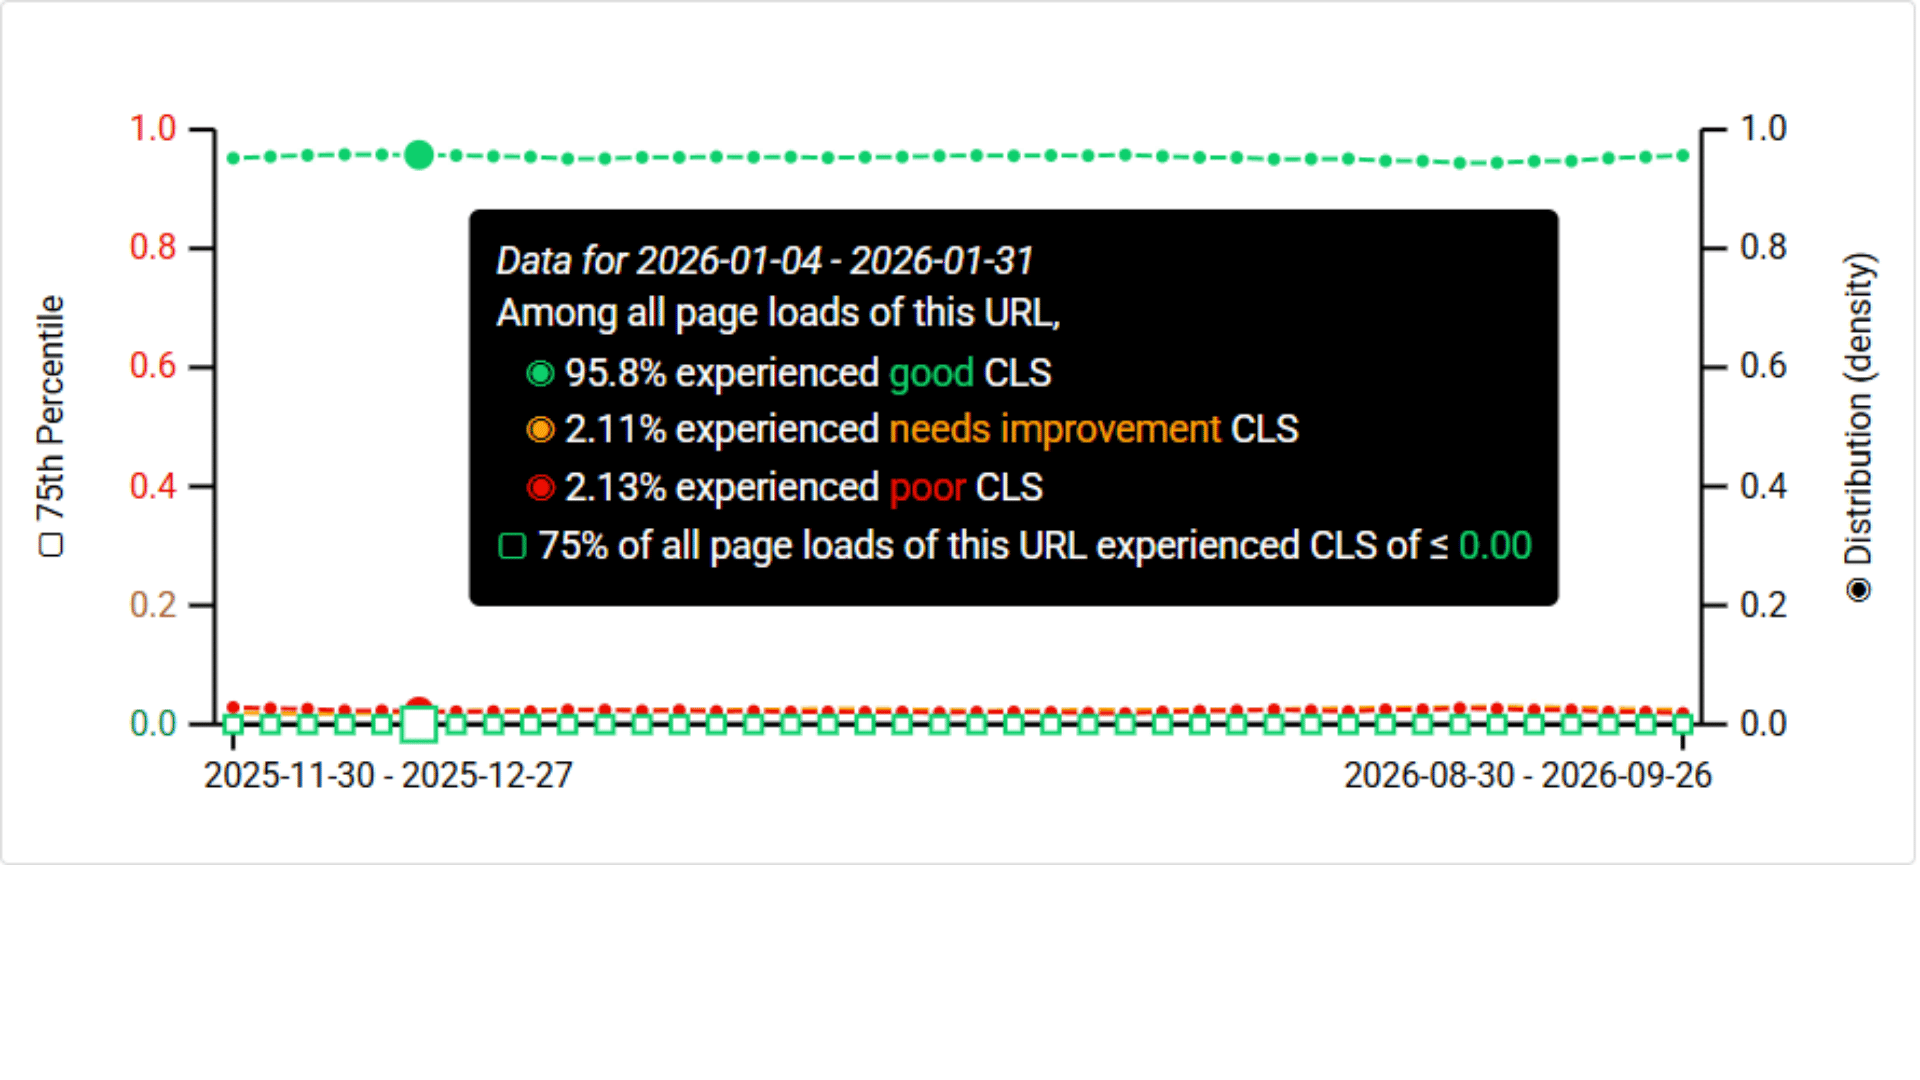
Nachher
- Good: 95,8 %
- Needs Improvement: 2,11 %
- Poor: 2,13 %
- CLS p75: 0,00
Der Anteil schlechter Erfahrungen fällt damit von 30,4 % auf 2,13 %. Der p75-Wert selbst fällt auf 0,00. Auch die Zeitreihe zeigt einen praktisch unmittelbaren Zusammenbruch des vorherigen CLS-Problems nach der Umstellung.
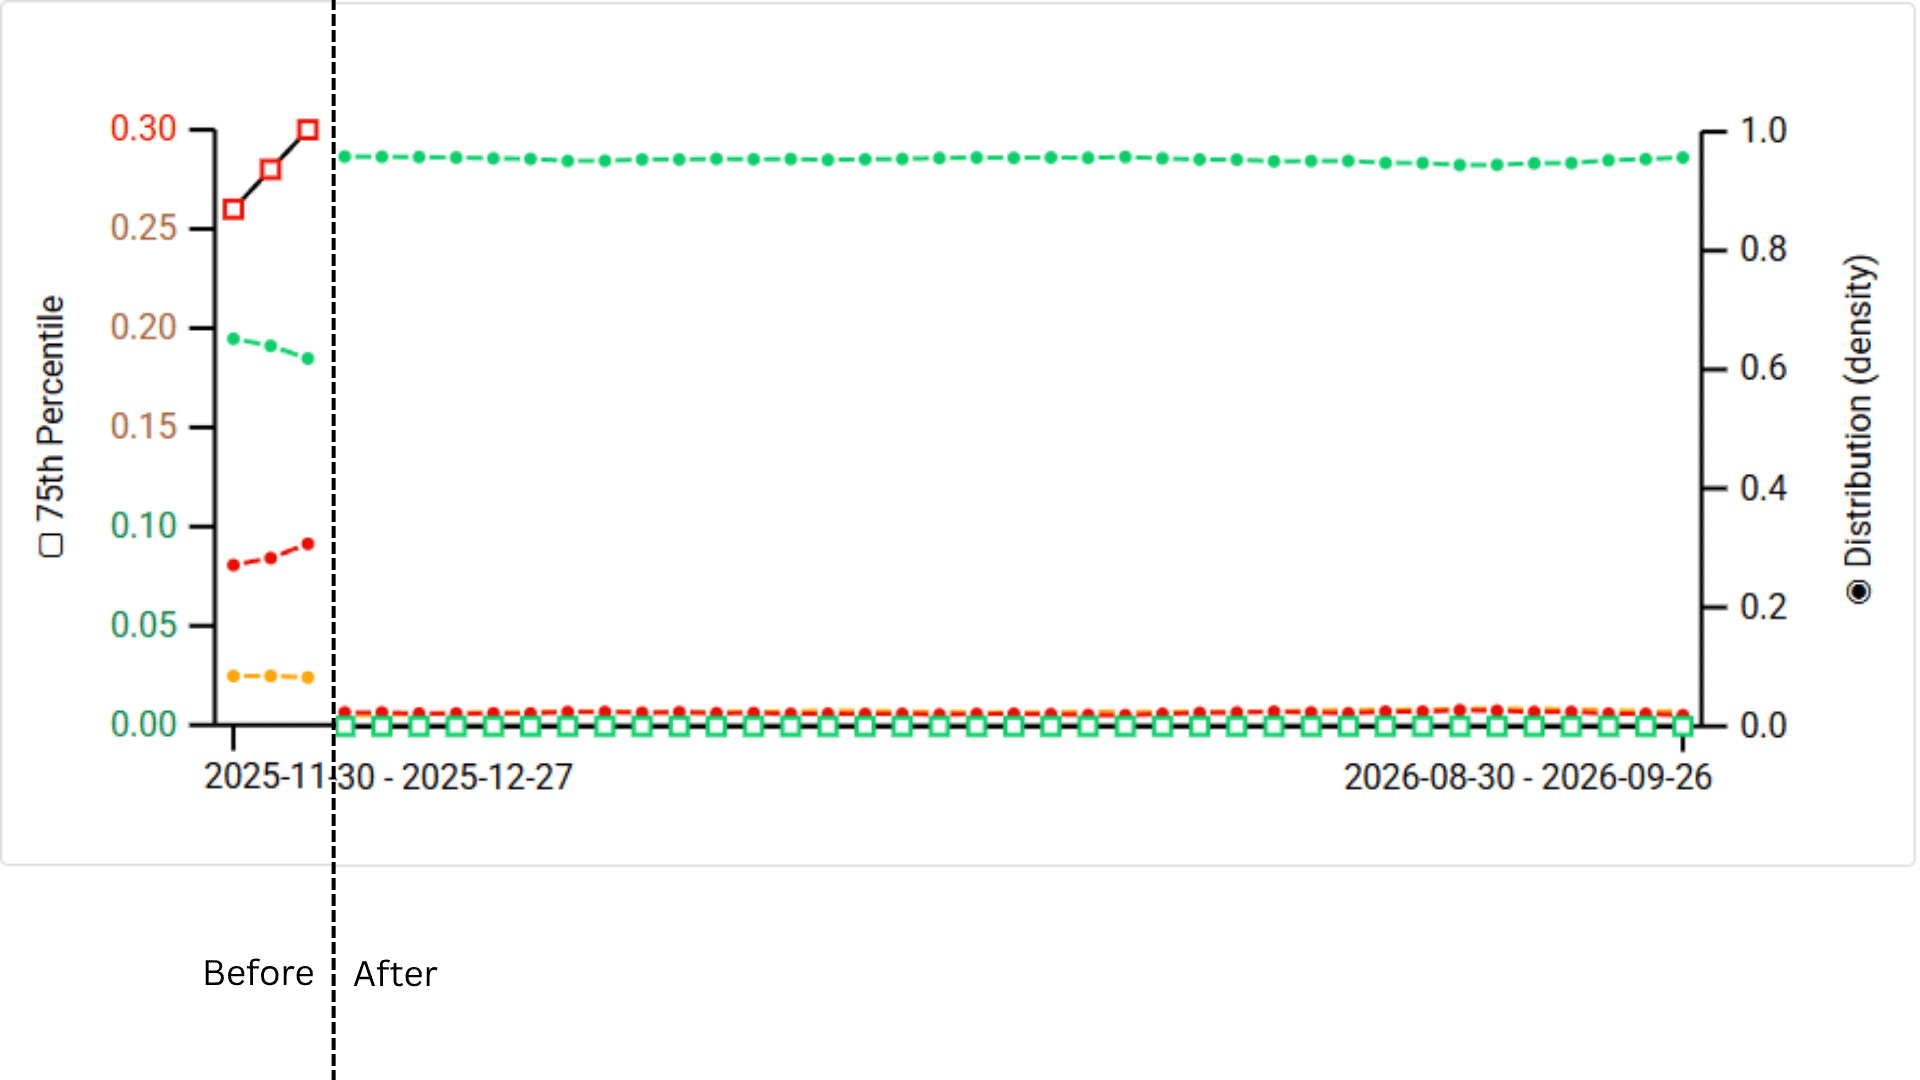
Der eigentlich interessante Skalierungseffekt
Die Performance-Zahlen allein wären bereits deutlich. Für OberpfalzECHO ist jedoch die Entwicklung des Systems entscheidender:
Zum Zeitpunkt der Migration
ca. 76.000 Artikel
Heute
~100.000 Artikel
Dazu kommt eine Redaktion, die kontinuierlich hunderte neue Beiträge pro Woche produziert. Der Datenbestand ist damit um mindestens 31,6 % gewachsen. Trotzdem zeigen die Messdaten:
- keine erkennbare Verschlechterung der TTFB,
- keine wachsende FCP-Latenz,
- keinen zunehmenden CLS,
- keinen steigenden LCP,
- sondern beim LCP sogar eine weitere Verbesserung im Zeitverlauf.
Das ist architektonisch relevant. In einem klassischen dynamischen WordPress-Frontend hängen Requests potentiell von zahlreichen Laufzeitfaktoren ab:
Beim OberpfalzECHO-Prototypen wurde diese Kopplung weitgehend aufgelöst:
Die Größe des redaktionellen Systems und die Kosten eines einzelnen öffentlichen Requests sind dadurch nicht mehr unmittelbar gekoppelt.
Fazit
OberpfalzECHO zeigt nicht nur einen klassischen Vorher-/Nachher-Performancegewinn. Die interessantere Erkenntnis ist die Entkopplung von Content-Wachstum und Frontend-Kosten. Seit der Einführung des frühen VeloCore Full-Headless-Prototypen ist das Portal von ungefähr 76.000 auf fast 100.000 Artikel angewachsen.
Trotz dieses Wachstums:
TTFB: 1.636 → 285 ms
FCP: 3.364 → 838 ms
LCP: 3.865 → 1.219 ms und anschließend weiter sinkend
CLS: 0,30 → 0,00
INP: 139 → 97 ms
Die Langzeitdaten zeigen damit zwei Dinge gleichzeitig: Der Architekturwechsel erzeugte einen sofortigen Performance-Sprung. Und:
Das deutlich größere System konnte dieses Niveau nicht nur halten – einzelne Kennzahlen verbesserten sich danach sogar weiter.
Hinweis zur Datengrundlage
Die Screenshots zeigen reale Chrome-Felddaten. Besonders aussagekräftig für den zeitlichen Architekturwechsel sind die jeweiligen gemeinsamen Vorher-/Nachher-Zeitreihen. Nachzuprüfen unter https://cruxvis.withgoogle.com/
CruX-Field-Daten ansehen